Живые дискуссии
Концепция "wiki LLM" Карпати и продуктивность баз знаний
@lapshinsite инициировал дискуссию, интересуясь концепцией "wiki LLM" Андрея Карпати как инструментом для повышения продуктивности в ведении баз знаний, автоматизации обработки источников, создания заметок и связей между ними. Он запросил опыт и пошаговые гайды по реализации (источник).
↳ Мнения и опыт участников:
- @rustamaga (в ответ @lapshinsite) назвал распространенную интерпретацию Карпати "полной ересью", утверждая, что большинство упускает его понятие "ingest" — глубокое "переваривание" информации, которое Карпати выполняет сам, а не делегирует LLM. По мнению @rustamaga, большая часть контента, обработанного LLM, станет "мусором" для личной базы знаний, так как это "НЕ МОЕ" (источник, источник). @lapshinsite объяснил свою мотивацию необходимостью быстрой обработки больших объемов информации для соблюдения дедлайнов (источник, источник). @rustamaga предположил, что проблема, требующая привлечения LLM для обработки больших объемов, лежит в иной плоскости, а не в отсутствии информации, и подобный подход с высокой вероятностью не принесет желаемого результата. Он подчеркнул, что "НИ одна проблема не решается с помощью 'мне нужно больше информации'" (источник, источник).
- @leins275 (в ответ @lapshinsite) поделился практическим опытом, отметив, что "LLM wiki" скорее "одноразовая история" для быстрого обзора множества источников, а попытка интегрировать такой подход во всю личную базу знаний не сработала (источник).
- @Alex_D73 (в ответ @lapshinsite) уточнил, что Карпати использует LLM для "моторики" (обработки источников, создания черновиков заметок и связей), но активно участвует в написании, направляет LLM и жестко контролирует/ревьювит результат, сохраняя смысловую часть за собой. Он также отметил, что для полноценной реализации подхода Карпати требуются неограниченный бюджет на LLM, доступ к передовым моделям и глубокие знания в области работы с LLM (источник).
- @tavor118 (в ответ @lapshinsite) предложил для реализации использовать VS Code с плагином для Claude или Claude Desktop, создав файл
claude.mdдля хранения правил и инструкций по работе с базой (источник). - @lapshinsite (в ответ @tavor118) сообщил о настройке собственной системы: автоматический бэкап на GitHub, установка ChatGPT на десктоп, создание структуры папок (Raw, Schema) в Obsidian по принципам Карпати, заброс источников и настройка доступа ChatGPT к папке. Он подтвердил, что система делает синтез знаний, а не просто конспектирует, назвав это "новым уровнем" (источник,
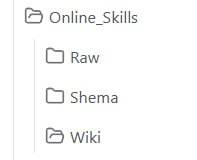 , источник, источник, источник).
- @leins275 рекомендовал дополнительный ресурс для изучения: https://github.com/nashsu/llm_wiki (источник,
 ).
Дискуссия о терминологии "Искусственного Интеллекта" и глубине обсуждений
@tst_bot_forward (в ответ @lapshinsite) поднял философский вопрос о мышлении в книгах и роли ИИ как следующего шага в развитии поисковиков, поставив под сомнение скептицизм в отношении ИИ по сравнению с книгами (источник, источник).
↳ Мнения участников:
- @leins275 (в ответ @tst_bot_forward) возразил, что термин "интеллект" в "Искусственном Интеллекте" вводит в заблуждение, мешая понять истинную суть инструмента, особенно для широких масс. Он предложил название "автоматический текстовый процессор" (источник, источник, источник, источник). @ladykosha предложила "Автоворд" (источник).
- @raan2222 (в ответ @leins275) поддержал идею о неточности термина, указав на отсутствие общепринятого определения "интеллекта", что позволяет использовать его "как помело". Он также упомянул книгу "Невидимая горилла" как пример ненадежности человеческого восприятия (источник, источник).
- @megalopsyhia выразил желание углубления дискуссий в чате, выходящих за рамки повторяющихся базовых тем (источник). @ladykosha (в ответ @megalopsyhia) отметила прикладной характер чата, предполагая, что для более глубоких тем, возможно, стоит искать другие площадки (источник). @rustamaga (в ответ @megalopsyhia) выразил готовность обсуждать глубинные темы, такие как Бахтин, Лотман, Бодрийар, и их принципы в контексте своей книги (источник).
Итоговая аналитика
День в группе "Управление знаниями" ознаменовался оживленной дискуссией о месте больших языковых моделей (LLM) в личных системах управления знаниями. Основная полемика развернулась между сторонниками использования LLM для повышения скорости и продуктивности обработки информации (@lapshinsite) и теми, кто призывает к более глубокому, человеческому "перевариванию" знаний, отводя LLM роль лишь вспомогательного инструмента для рутинных операций (@rustamaga, @leins275). Эмоциональный фон был насыщенным, варьируясь от энтузиазма первопроходцев до скептицизма опытных практиков.
Ключевые выводы включают согласие, что LLM способны выполнять синтез знаний, а не только конспектирование, однако их эффективное применение требует глубокого понимания технологии, жесткого контроля со стороны пользователя и значительных ресурсов. Отмечено, что термин "Искусственный Интеллект" часто вводит в заблуждение, порождая неверные ожидания от возможностей инструмента.
Информационные пробелы дня заключаются в отсутствии долгосрочных кейсов успешного внедрения "wiki LLM" для полноценных личных баз знаний, подтвержденных метриками качества, а не только скорости. Обсуждение выявило потенциальный риск формирования завышенных ожиданий от LLM в PKM, что может привести к разочарованию при попытке заменить глубокую человеческую аналитическую работу. Тем не менее, первые отчеты @lapshinsite о запуске собственной системы показывают потенциал для значительного ускорения начальных этапов работы с информацией при правильном подходе и понимании ограничений.
Источники
источник источник источник источник источник источник источник источник источник источник источник источник источник источник источник источник источник источник источник источник источник источник источник источник источник источник источник источник источник источник источник источник источник источник источник источник источник источник источник источник источник источник источник источник источник